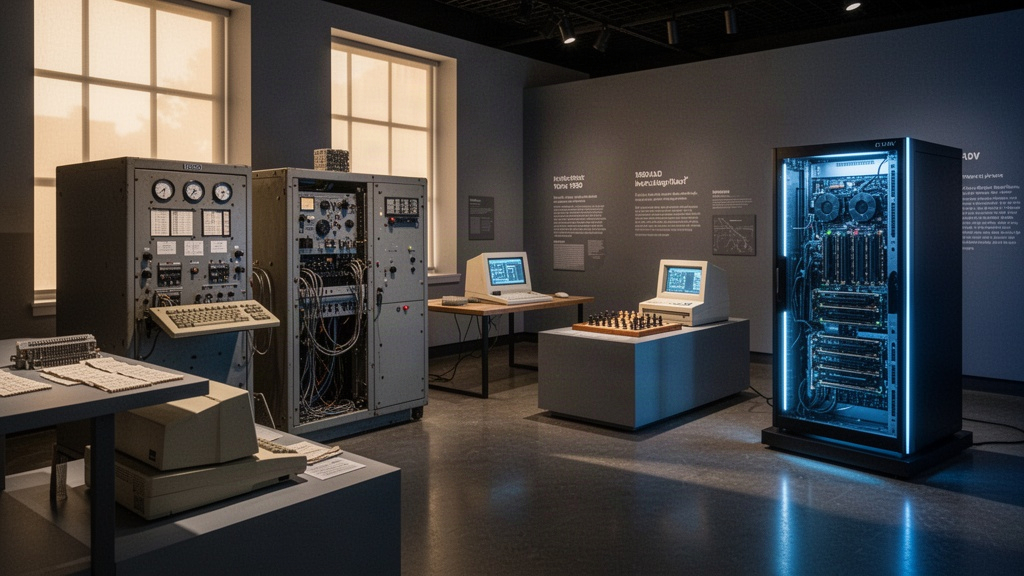
L'histoire de l'IA s'étend sur plus de sept décennies de recherches, d'échecs, de rebonds et d'accélérations spectaculaires. Derrière chaque avancée se trouvent des chercheurs, des institutions et des machines qui ont repoussé les limites de ce que l'on croyait possible. Des premières questions théoriques d'Alan Turing jusqu'aux modèles génératifs déployés à l'échelle mondiale, le chemin parcouru est vertigineux. Cette trajectoire n'est pas linéaire : elle est jalonnée de périodes d'enthousiasme, de désillusions brutales et de renaissances inattendues. Comprendre cette évolution, c'est aussi mieux saisir les enjeux actuels — économiques, techniques et réglementaires — qui façonnent le Web et la société numérique d'aujourd'hui.
- 1950 : Alan Turing publie « Computing Machinery and Intelligence » et introduit le test de Turing
- 1956 : La conférence de Dartmouth fonde officiellement le domaine de l'intelligence artificielle
- 1966 : ELIZA, premier programme conversationnel, est créée au MIT par Joseph Weizenbaum
- 1986 : Rumelhart, Hinton et Williams popularisent la rétropropagation du gradient
- 1997 : Deep Blue d'IBM bat le champion du monde d'échecs Garry Kasparov
- 2012 : AlexNet domine la compétition ImageNet et relance l'apprentissage profond
- 2016 : AlphaGo de DeepMind bat le champion de go Lee Sedol
- 2017 : L'article « Attention Is All You Need » introduit l'architecture Transformer
- 2022 : OpenAI rend ChatGPT accessible au grand public en novembre
- 2024 : L'AI Act de l'Union européenne entre en vigueur le 1er août
Les fondations de l'histoire de l'IA : de Turing à Dartmouth
Tout commence par une question simple, posée en 1950 par le mathématicien britannique Alan Turing : « Les machines peuvent-elles penser ? » Dans son article « Computing Machinery and Intelligence », Turing propose une expérience de pensée restée célèbre sous le nom de test de Turing. Le principe : si une machine parvient à dialoguer avec un humain de façon suffisamment convaincante pour que celui-ci ne puisse pas distinguer son interlocuteur d'un être humain, alors on peut raisonnablement parler d'intelligence.
Cette question n'émerge pas du néant. Les années 1940 voient se développer la cybernétique, portée notamment par Norbert Wiener, ainsi que les premiers travaux sur les réseaux neuronaux formels de Warren McCulloch et Walter Pitts. Claude Shannon, à la même époque, jette les bases de la théorie de l'information. Ces courants convergent vers une même intuition : le cerveau humain pourrait être modélisé, au moins partiellement, par des systèmes formels.
Six ans après Turing, en 1956, une réunion d'été au Dartmouth College officialise la naissance d'un nouveau champ de recherche. John McCarthy, qui organise l'événement avec Marvin Minsky, Claude Shannon et d'autres, choisit l'expression « intelligence artificielle » pour désigner ce projet collectif. L'ambition affichée est considérable : reproduire, en quelques années, les capacités cognitives humaines dans des programmes informatiques. Cette conférence ne représente pas un point de départ absolu — les travaux antérieurs en logique, statistiques et informatique y contribuaient déjà — mais elle donne au domaine un nom, une identité et une communauté.
Les années qui suivent sont marquées par un optimisme débordant. Des programmes comme le Logic Theorist de Newell et Simon démontrent que des machines peuvent résoudre des théorèmes mathématiques. Les financements affluent, notamment aux États-Unis. La conviction partagée est que l'intelligence générale artificielle est à portée de main. Cette certitude sera sévèrement éprouvée dans les décennies suivantes.
À lire aussi : Design web : cap sur les nouvelles tendances pour un site séduisant
Des règles aux systèmes experts : premiers espoirs et hivers de la recherche
L'approche dominante des années 1960 à 1980 repose sur ce qu'on appelle l'IA symbolique : représenter les connaissances humaines sous forme de règles logiques explicites, puis laisser la machine raisonner à partir de ces règles. En 1966, Joseph Weizenbaum au MIT crée ELIZA, un programme capable de simuler une conversation en reformulant les phrases de son interlocuteur selon des schémas prédéfinis. Le résultat surprend : des utilisateurs s'y attachent émotionnellement, convaincus d'interagir avec une entité dotée de compréhension. Weizenbaum lui-même en est troublé.
Dans les années 1970 et 1980, les systèmes experts prennent le relais. Ces programmes encodent le savoir de spécialistes — médecins, ingénieurs, juristes — dans des bases de règles consultables. MYCIN, développé à la Stanford University, diagnostique des infections bactériennes avec une précision comparable à celle de certains médecins humains. Des entreprises investissent massivement dans cette technologie.
Puis viennent les désillusions. Les systèmes experts s'avèrent fragiles : ils ne fonctionnent que dans des domaines très étroitement définis, nécessitent une maintenance constante et peinent à gérer l'incertitude. La puissance de calcul disponible bute sur la complexité des problèmes réels. Les organismes de financement, notamment au Royaume-Uni avec le rapport Lighthill en 1973 et aux États-Unis à la fin des années 1980, réduisent drastiquement leurs investissements. Ces périodes de désintérêt et de coupes budgétaires sont connues sous le nom d'hivers de l'IA. Deux cycles majeurs se succèdent, forçant la communauté scientifique à revoir ses ambitions à la baisse et à chercher des approches radicalement différentes.
Ces hivers ne sont pas des échecs totaux. Ils contraignent les chercheurs à mieux définir les problèmes, à développer des méthodes plus rigoureuses et à abandonner les promesses non tenues. Le terrain est ainsi préparé pour une mutation profonde de la discipline.
Quand les données et le calcul changent tout
Le tournant des années 1980-1990 voit émerger une approche différente : plutôt que de coder des règles à la main, laisser la machine apprendre à partir d'exemples. L'apprentissage automatique gagne en crédibilité. En 1986, la publication de Rumelhart, Hinton et Williams popularise l'algorithme de rétropropagation du gradient, qui permet d'entraîner des réseaux neuronaux à plusieurs couches de manière efficace. Cette avancée technique reste longtemps sous-exploitée, faute de données et de puissance de calcul suffisantes.
À lire aussi : Les avantages d'une google fiche entreprise bien remplie en 2026
Les années 1990 apportent pourtant une démonstration spectaculaire. En 1997, Deep Blue, le superordinateur d'IBM, bat Garry Kasparov, champion du monde d'échecs en titre, lors d'un match officiel. Ce résultat secoue l'opinion publique. Beaucoup y voient la preuve que les machines peuvent surpasser l'humain dans des domaines cognitifs complexes. Les spécialistes, eux, soulignent que Deep Blue repose sur une recherche exhaustive dans un espace de jeu bien défini, et non sur une intelligence générale comparable à celle de Kasparov.
La progression des capacités de calcul, la multiplication des données disponibles sur Internet et les améliorations algorithmiques créent, dans les années 2000, les conditions d'une nouvelle accélération. Les méthodes statistiques et les réseaux neuronaux gagnent du terrain dans des applications concrètes : filtrage de spam, reconnaissance vocale, recommandation de contenu. NVIDIA développe des processeurs graphiques (GPU) qui s'avèrent particulièrement adaptés aux calculs parallèles nécessaires à l'entraînement des modèles. Sans cette évolution matérielle, la suite de l'histoire aurait été impossible.
De 2012 à 2022 : l'apprentissage profond prend la main
L'année 2012 marque un basculement net. Le réseau de neurones AlexNet, développé par une équipe de l'Université de Toronto, remporte la compétition ImageNet avec un taux d'erreur bien inférieur à celui de ses concurrents. Cette performance démontre que l'apprentissage profond — des réseaux neuronaux à de nombreuses couches — peut traiter des images avec une précision inédite. La communauté scientifique et les grandes entreprises technologiques prennent acte. Google, Facebook, Microsoft et d'autres recrutent massivement des spécialistes de ces architectures.
En 2016, AlphaGo de DeepMind bat Lee Sedol, l'un des meilleurs joueurs de go au monde. Le jeu de go était longtemps considéré comme hors de portée des machines, en raison de la complexité astronomique de son espace de jeu. AlphaGo combine apprentissage par renforcement et réseaux neuronaux profonds pour y parvenir. La victoire est sans appel : 4 parties à 1.
Un an plus tard, en 2017, des chercheurs de Google publient l'article « Attention Is All You Need », qui présente l'architecture Transformer. Ce modèle repose sur des mécanismes d'attention permettant de traiter les relations entre tous les éléments d'une séquence simultanément, plutôt que séquentiellement. Cette propriété le rend particulièrement efficace pour le traitement du langage. GPT, BERT et leurs successeurs en découlent directement.
À lire aussi : Intégration des réseaux sociaux dans la création de sites web : une stratégie incontournable
En novembre 2022, OpenAI rend ChatGPT accessible au public. En quelques jours, des millions d'utilisateurs interagissent avec un modèle de langage capable de rédiger, d'expliquer, de coder et de converser sur presque n'importe quel sujet. L'IA générative entre dans le quotidien de millions de personnes, bien au-delà des cercles scientifiques et technologiques.
L'IA aujourd'hui : modèles de fondation, usages et régulation
Les modèles de fondation — ces systèmes entraînés sur des volumes massifs de données et adaptables à de nombreuses tâches — redéfinissent ce que le Web peut offrir. Rédaction assistée, génération d'images, traduction automatique, synthèse de documents, assistance à la programmation : les usages prolifèrent dans tous les secteurs. Pour les professionnels du Web, ces outils modifient les pratiques de création de contenu, de référencement et d'expérience utilisateur.
Cette diffusion rapide soulève des questions sérieuses. Les biais présents dans les données d'entraînement se retrouvent dans les sorties des modèles. La consommation énergétique de l'entraînement et de l'inférence est considérable. La fiabilité des informations générées reste variable, avec des hallucinations documentées dans tous les grands modèles. Le National Institute of Standards and Technology (NIST) aux États-Unis travaille à des cadres de gestion des risques liés à l'IA.
Sur le plan réglementaire, l'Union européenne a adopté l'AI Act, entré en vigueur le 1er août 2024. Ce texte classe les systèmes d'IA par niveau de risque et impose des obligations progressives aux développeurs et déployeurs. Certaines obligations s'appliquent progressivement jusqu'en 2026 : les acteurs concernés doivent suivre le calendrier officiel publié par la Commission européenne pour connaître leurs échéances précises.
L'histoire de l'IA n'est pas celle d'une progression mécanique vers une intelligence toujours plus grande. C'est une succession de paris, de déceptions et de découvertes fortuites portées par des individus et des institutions qui ont accepté de remettre en question leurs hypothèses. Les prochaines étapes — vers des systèmes plus fiables, plus transparents et mieux gouvernés — dépendront autant des choix politiques et éthiques que des avancées techniques. Ce que sept décennies de recherche ont montré avec constance : les limites d'aujourd'hui ne dessinent pas celles de demain.